3.3 Bonnes pratiques et mise en pratique des données spatiales probantes !
Adopter de bonnes habitudes pour organiser son projet et se lancer dans la pratique
Les sections 3.1 et 3.2 ont présenté l’origine des données spatiales probantes et les outils que nous utiliserons pour les exploiter. Dans cette section, nous abordons brièvement quelques bonnes pratiques pour organiser un projet afin qu’il reste facile à gérer, ainsi qu’un flux de travail général applicable à toute tâche liée aux données spatiales.
3.3.1 Organiser notre projet et nos fichiers
Avant de commencer : configurer le projet
Une bonne organisation du projet est essentielle pour garder une trace des données d’entrée, des scripts et des résultats, et pour garantir que notre travail soit reproductible et puisse être partagé. Quelques habitudes simples contribuent largement à rendre notre travail plus facile à gérer et plus transparent.
Lorsque nous ouvrons ou créons un nouveau projet, la première étape consiste à créer un projet RStudio (File → New Project). Un projet RStudio regroupe nos scripts, nos données et nos résultats dans un seul dossier autonome.
Ensuite, nous devons définir la structure de nos dossiers (avant d’ajouter des données ou d’écrire du code), afin que chaque élément ait sa place dès le départ, plutôt que de devoir tout démêler et réorganiser par la suite. Une bonne structure de dossiers est simple et cohérente. Par exemple :
my-project/
├── data/
│   ├── raw/            # données telles qu'elles ont été téléchargées ou récupérées (non modifiées)
│   └── processed/      # données nettoyées ou traitées que nous avons produites
├── scripts/            # nos scripts R, dans l'ordre de leur exécution
├── outputs/            # cartes, tableaux et figures que nous produisons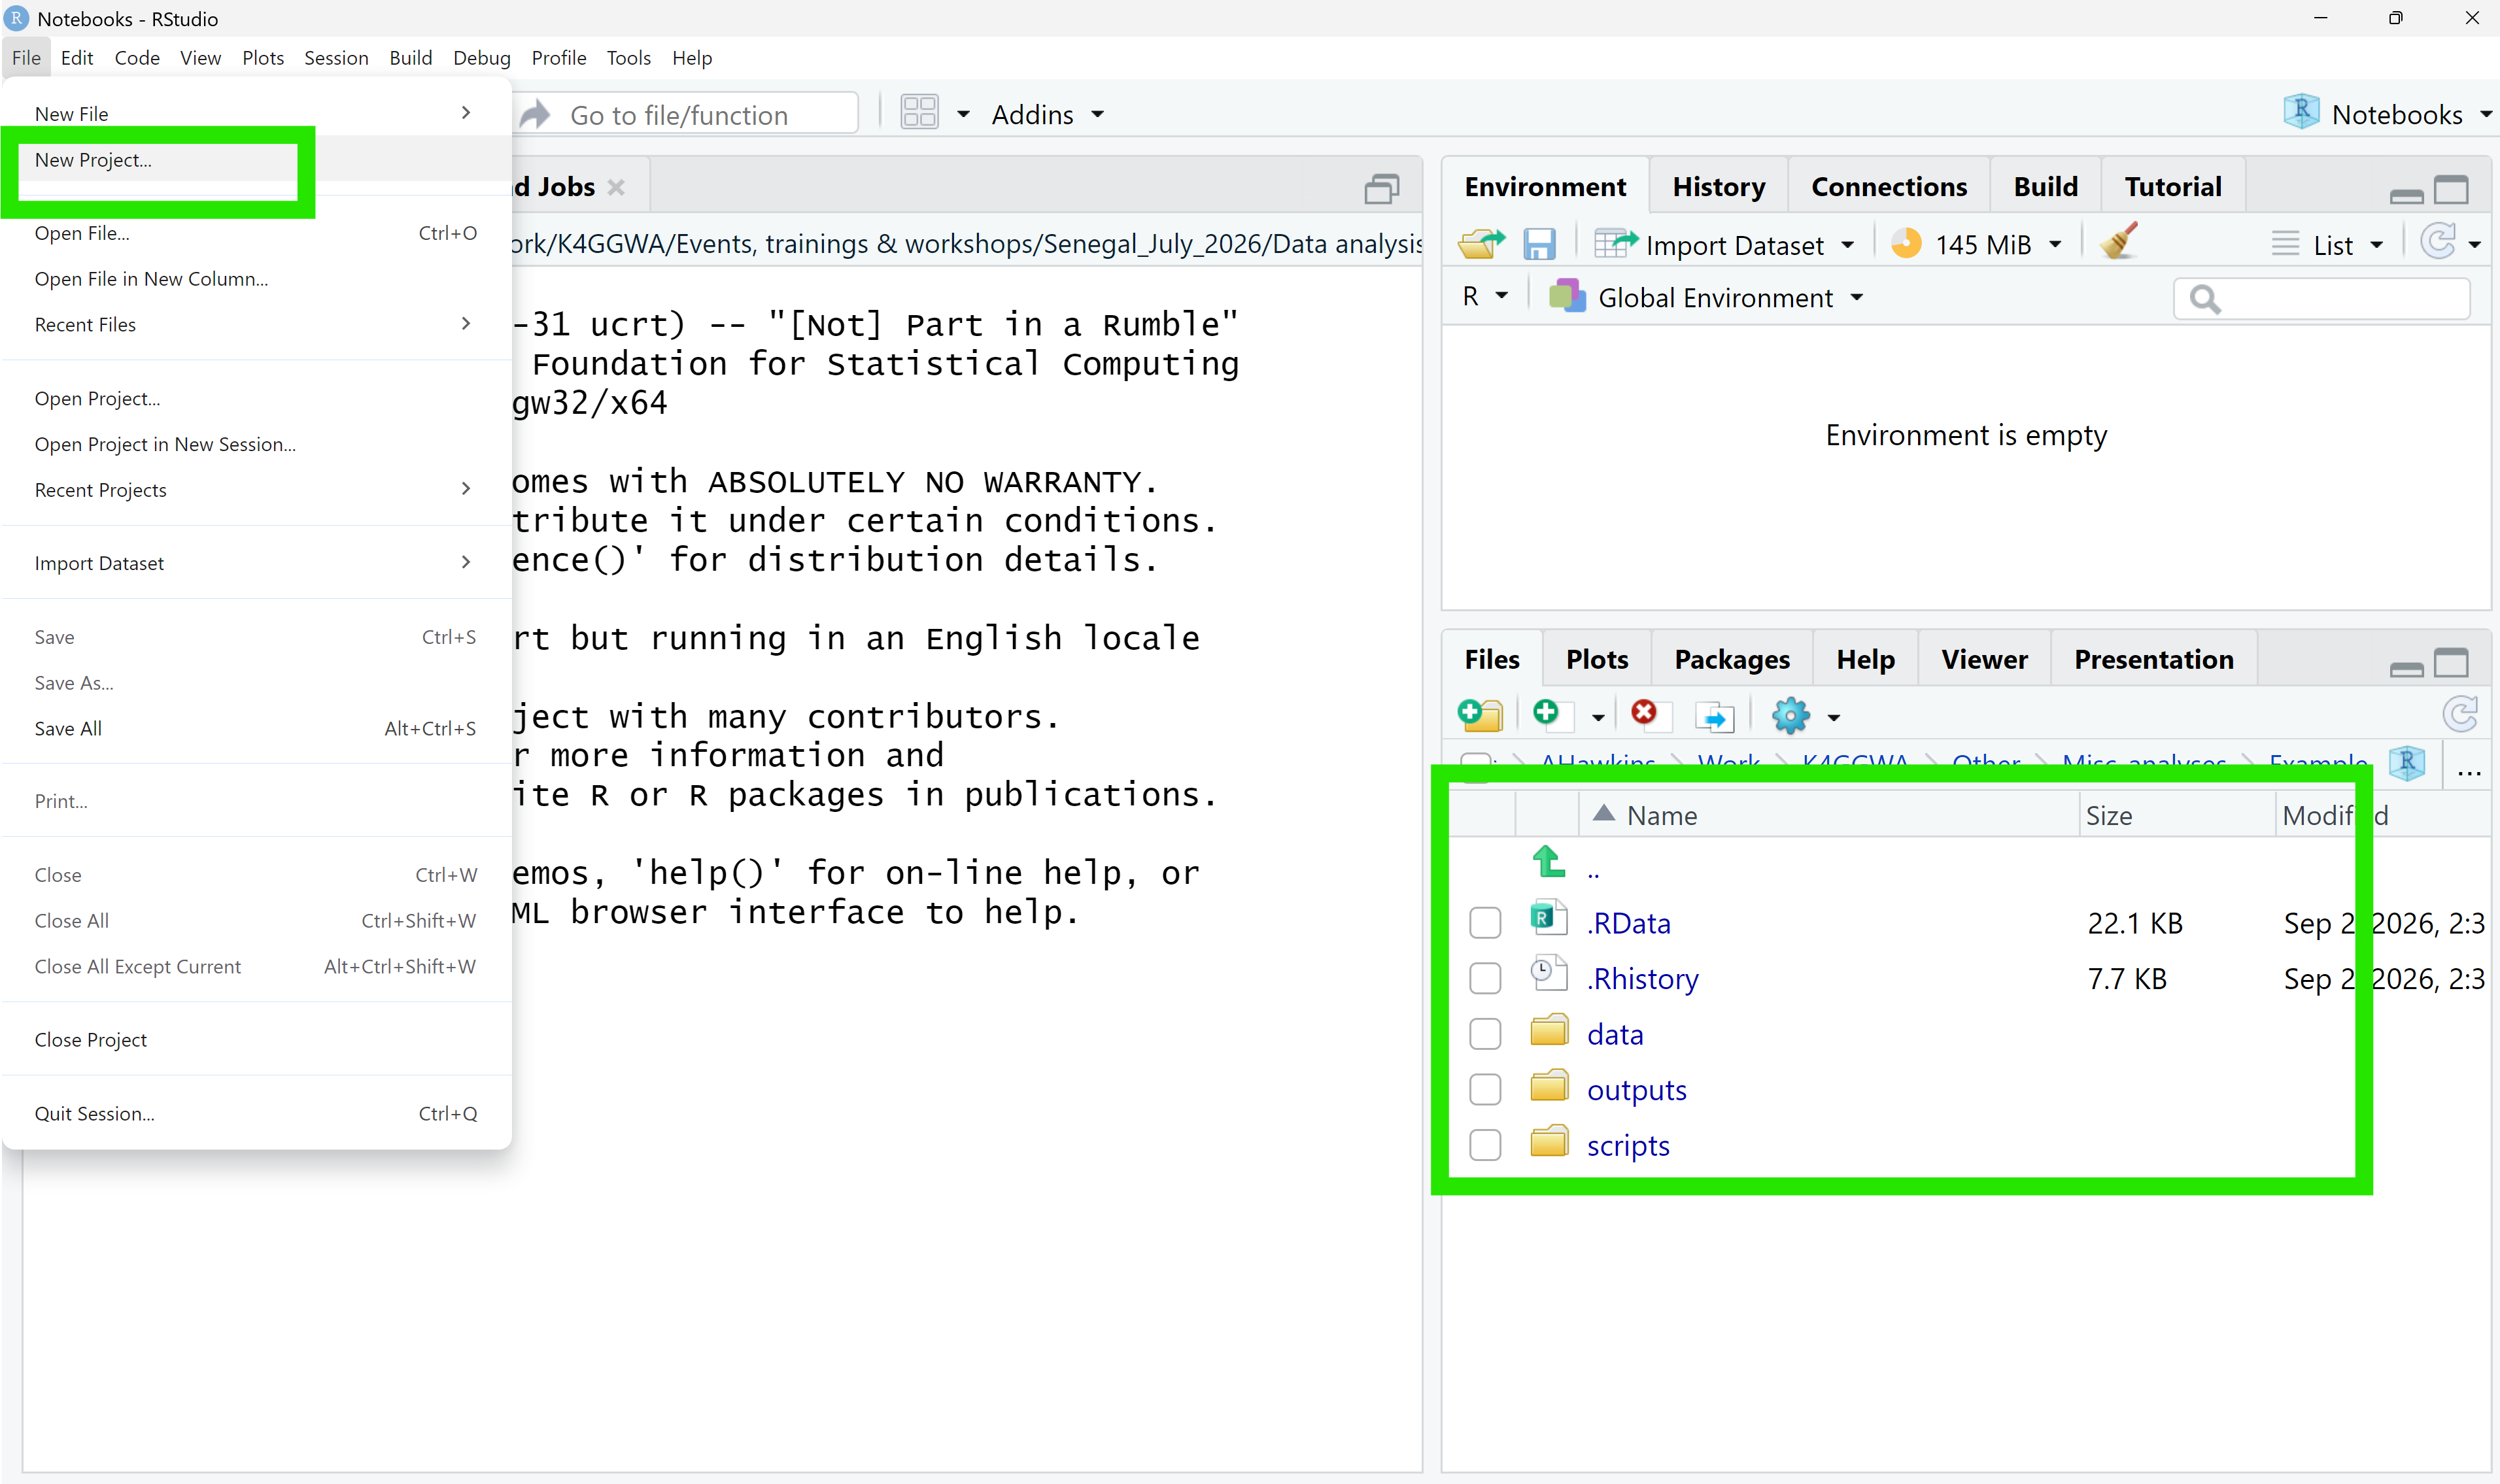
Voici quelques habitudes utiles à adopter, quelle que soit la structure de notre projet :
Éviter de modifier directement les données brutes. Conservez le fichier exactement tel qu’il a été obtenu dans data/raw/, et effectuez tout nettoyage ou toute correction à l’aide de code qui génère un nouveau fichier dans data/processed/. Cela permet de préserver la provenance des données et de répondre aux questions relatives aux métadonnées abordées dans la section 2.2.2. Si un problème apparaît ultérieurement, nous pouvons toujours remonter jusqu’au fichier d’origine.
Utiliser des noms de fichiers et de dossiers cohérents et descriptifs. Privilégiez les minuscules, les tirets ou les tirets bas à la place des espaces, et le format de date YYYY-MM-DD lorsqu’un nom de fichier doit inclure une date. Cela permet de retrouver, de partager et de comprendre facilement les fichiers, même longtemps après leur création.
3.3.2 Un flux de travail général pour les tâches liées aux données spatiales
Une fois notre projet configuré, nous pouvons suivre un flux de travail relativement standard :
Définir Formuler la question ou la
décision à éclairer
Trouver les données Localiser des jeux de données
pertinents et adaptés aux besoins
Charger, nettoyer, examiner Importer les données,
vérifier le SCR, l’étendue,
la résolution et les valeurs manquantes
Analyser Combiner, résumer
ou modéliser
Interpréter et communiquer Présenter les résultats,
en précisant les incertitudes pertinentes
| 1. Définir la question ou la décision | Avant de manipuler des données, il est important de définir clairement la question à laquelle nous souhaitons répondre ou la décision que nous cherchons à éclairer. Ce principe a déjà été souligné dans la section 1.1, consacrée au cycle décisionnel de la restauration, ainsi que dans la section 3.1. Cette étape détermine tout ce qui suit, notamment les données qui nous aideront à répondre à la question et à traiter le problème posé. |
| 2. Trouver les données | Une fois la question définie, la section 3.1 explique comment découvrir et accéder aux données probantes pertinentes, que ce soit par l’intermédiaire de notre catalogue STAC ou d’un autre fournisseur. Gardez à l’esprit les éléments à prendre en compte lors de l’utilisation des données spatiales, présentés dans la section 2.2.2 : quelle est la variable représentée ? Comment a-t-elle été produite ? Avec quel niveau de confiance ou d’incertitude puis-je l’utiliser ? |
| 3. Charger les données | Importez les données dans R. Utilisez {rstac} pour trouver une ressource (asset), puis {terra}, {sf} et d’autres packages adaptés à la manipulation des données pour les lire. Le notebook d’initiation de la galerie d’exercices pratiques présente précisément ces étapes à partir de notre propre catalogue STAC. |
| 4. Nettoyer et examiner les données | Avant de commencer toute analyse, vérifiez les éléments essentiels : le système de coordonnées de référence (SCR) est-il cohérent entre tous nos jeux de données et toutes nos couches ? L’étendue géographique couvre-t-elle effectivement notre zone d’intérêt ? Quelle est la résolution des données et est-elle adaptée à notre question, conformément aux critères d’échelle présentés dans la section 2.2.2 ? Existe-t-il des valeurs manquantes ou des valeurs NoData dont il faut tenir compte ? |
| 5. Analyser | C’est ici que le travail d’analyse prend véritablement forme ! Il peut s’agir de combiner des couches, de résumer des valeurs dans une zone d’intérêt ou de réaliser une modélisation statistique, comme dans l’exemple de prise de décision présenté dans la section 1.3.3. |
| 6. Interpréter et communiquer | Enfin, nous examinons nos résultats, les mettons en perspective par rapport à la question initiale et les communiquons conformément aux principes présentés dans la section 2.2.3 : de manière claire, en précisant les niveaux de confiance, les réserves et les limites. |
Ce flux de travail n’est pas un processus rigide et linéaire. Dans les projets réels, il est fréquent de revenir sur certaines étapes et de les répéter, en particulier lors du chargement, du nettoyage et de l’analyse des données.
Maintenant que notre projet est bien organisé et que nous disposons d’un flux de travail pour nous guider, nous sommes prêts à passer à la pratique avec de vraies données et des situations concrètes de prise de décision ! Rendez-vous dans la galerie de tutoriels, où vous pourrez mettre en application toutes ces notions à partir de données réelles sur la Grande Muraille Verte.
Pour en savoir plus
Le guide officiel de Posit sur l'utilisation des projets dans RStudio pour organiser son travail et le rendre reproductible.
L'article de Jenny Bryan, largement lu et cité, qui défend les flux de travail organisés autour des projets et l'utilisation de chemins d'accès relatifs dans R.