3.1 Trouver et accéder aux données probantes spatiales
De l’infrastructure ouverte et infonuagique au catalogue STAC de la GMV
Pour être efficaces, les décisions de restauration dans le cadre d’initiatives multinationales de grande envergure comme la GMV (Grande Muraille Verte) reposent sur des données probantes comparables, cohérentes, transparentes et adaptables à l’échelle de paysages et d’institutions très différents. Nous l’avons exploré dans les modules 1.1 et 1.2.
Le module 2 a présenté ce que l’on entend par données probantes spatiales, la manière dont elles sont généralement générées et les points à considérer pour les utiliser de façon responsable.
Il est maintenant temps de mettre la main à la pâte et de produire nos propres données probantes spatiales !
3.1.1 Découverte des données et accès
Le passage vers des données ouvertes et infonuagiques
Historiquement, les jeux de données spatiales étaient difficiles à découvrir et à obtenir : les données se trouvaient souvent sur des serveurs d’organismes gouvernementaux, d’établissements de recherche ou de fournisseurs commerciaux, avec peu d’informations sur les données disponibles ou sur la manière de les obtenir. Il fallait généralement demander un jeu de données, le télécharger en entier et travailler avec un logiciel SIG de bureau, ce qui pouvait être lent et fastidieux, en particulier pour les grands jeux de données.
Ce flux de travail existe toujours et reste parfois le plus approprié, selon la tâche à accomplir. Toutefois, ce n’est plus la seule façon de travailler, ni souvent la plus efficace.
Les données d’observation de la Terre et d’autres jeux de données spatiales sont de plus en plus souvent publiés sous forme de données ouvertes hébergées dans le nuage. Au lieu de télécharger un jeu de données complet avant de pouvoir l’utiliser, on peut le découvrir dans un catalogue, interroger uniquement les parties nécessaires et y accéder directement depuis le nuage.
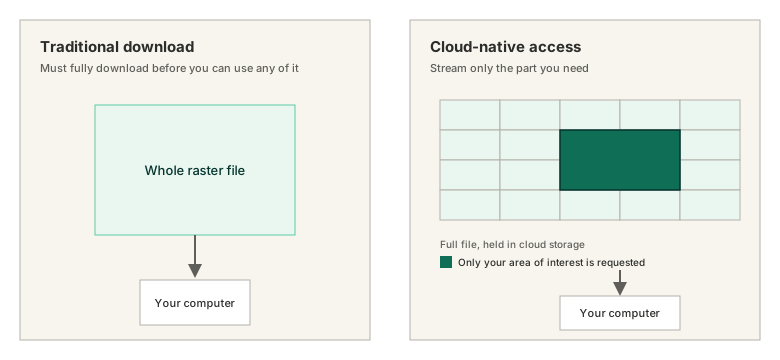
Pour un petit jeu de données ou une analyse ponctuelle, télécharger un fichier peut rester l’option la plus simple. En revanche, lorsqu’on travaille avec de vastes archives d’observation de la Terre, par exemple pour analyser l’évolution de la végétation dans les 11 pays de la Grande Muraille Verte sur plusieurs décennies, pouvoir découvrir et consulter les données de manière sélective permet d’économiser beaucoup d’espace de stockage, de temps de téléchargement et d’efforts de traitement.
3.1.2 Sources, fournisseurs et formats de données
Les données spatiales ouvertes sont mises à disposition de plusieurs façons :
- Géoportails de données : sites web gouvernementaux ou institutionnels où l’on peut parcourir et télécharger des jeux de données, souvent organisés autour d’un pays, d’un thème ou d’un projet précis.
- Catalogues de données : index structurés et interrogeables de jeux de données, couvrant parfois de nombreux fournisseurs à la fois.
- Plateformes infonuagiques et API : des services tels que Google Earth Engine, AWS Open Data ou Microsoft Planetary Computer, qui hébergent d’énormes volumes de données et permettent de les interroger et de les diffuser par programmation plutôt que de télécharger les fichiers un à un.
Consultez le chapitre 5 - Acquisition de données géospatiales de Geospatial Data Science with R and Python (en anglais) pour un aperçu plus détaillé des différentes façons d’accéder aux données spatiales.
Pour avoir une idée plus précise des différents fournisseurs et points d’accès qui existent, consultez cette liste de catalogues de données géospatiales ouvertes, compilée et tenue à jour par la communauté.
Les données sont également stockées dans divers formats, et de plus en plus dans des équivalents natifs du nuage qui rendent possibles la diffusion en continu et l’accès partiel :
| Type de données | Format(s) traditionnel(s) | Équivalent natif du nuage |
|---|---|---|
| Raster (voir 2.1.1) | GeoTIFF, PNG, NetCDF, HDF5 | Cloud Optimized GeoTIFF (COG), Zarr |
| Vecteur (voir 2.1.1) | Shapefile, GeoJSON, KML, GPKG | GeoParquet, FlatGeobuf, tuiles vectorielles |
| Multidimensionnel / séries temporelles | NetCDF, HDF5, GRIB | Zarr |
| Nuages de points | LAS, LAZ | COPC (Cloud Optimized Point Cloud) |
Ce tableau donne un aperçu des noms de formats et des types d’extensions de fichiers que nous rencontrerons en travaillant avec des jeux de données ouverts hébergés dans le nuage. Les données de ce portail sont publiées sous forme de Cloud Optimized GeoTIFF (COG), sur lesquels nous reviendrons sous peu.
3.1.3 STAC : SpatioTemporal Asset Catalog
Parmi tous ces portails, catalogues et API, une spécification en particulier est devenue le langage commun que de nombreux fournisseurs utilisent désormais pour rendre leurs données repérables : STAC, le SpatioTemporal Asset Catalog.
STAC est né en 2017, lorsque la Radiant Earth Foundation a réuni une douzaine d’organisations, dont Amazon, Google et Planet, entre autres actrices de l’imagerie satellitaire et des logiciels géospatiaux libres, autour d’un problème commun : l’API de recherche et le catalogage des données de chaque fournisseur fonctionnaient différemment, ce qui rendait difficile la recherche simultanée dans plus d’un fournisseur. STAC a résolu ce problème grâce à une spécification ouverte et simple permettant de décrire les données spatiales de façon uniforme, quel que soit leur éditeur. Elle a depuis été adoptée par bon nombre des plus grands fournisseurs de données spatiales ouvertes, y compris de grandes plateformes infonuagiques et satellitaires.
Un catalogue STAC organise les données selon une hiérarchie simple et cohérente :
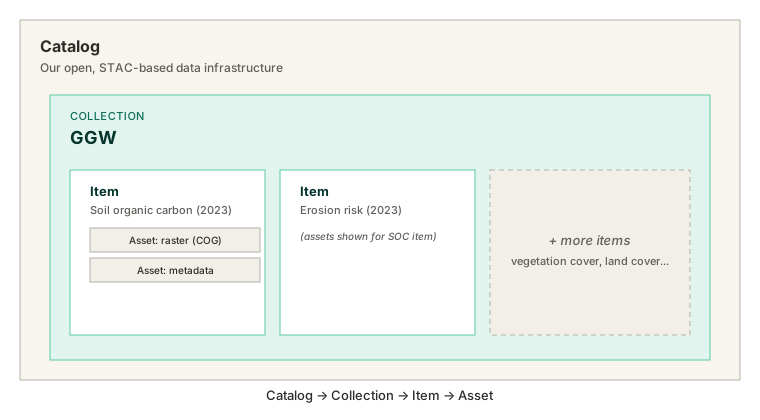
- Un catalogue (catalog) est le conteneur de niveau supérieur : l’ensemble de l’infrastructure de données que vous parcourez.
- Une collection regroupe des données apparentées, par exemple notre collection GMV.
- Un élément (item) est un jeu de données unique au sein d’une collection, par exemple la couche de prédiction du carbone organique du sol de 2023, ou la couche d’érosion.
- Un actif (asset) est un fichier concret rattaché à un élément, par exemple le raster lui-même ou ses métadonnées.
Chaque élément est accompagné de métadonnées cohérentes décrivant ce qu’il représente, y compris sa couverture spatiale et temporelle. Comme cette structure est la même partout, les mêmes outils et la même approche nous permettent de découvrir et d’obtenir des données auprès de n’importe quel fournisseur conforme à STAC, sans avoir à nous débattre avec le système propre à chacun. Nous pouvons ainsi répondre rapidement, quelle que soit la provenance des données, aux questions de vérification diligente de la section 2.2.2.
Les actifs des catalogues STAC peuvent être intégrés à des applications et à des cartes web pour une navigation visuelle (par exemple, nos propres tableaux de bord GMV), ce qui est excellent pour une exploration rapide sans écrire de code. Mais ils sont mieux exploités par programmation : interroger un catalogue directement depuis du code nous permet de rechercher, filtrer et récupérer exactement les données dont nous avons besoin dans notre espace de travail, c’est l’approche vers laquelle tend le reste de ce module.
Dans ce portail, nous nous référerons à la collection STAC de la GMV et l’utiliserons comme principale source de données probantes spatiales. Elle contient de nombreux jeux de données sur le climat, les sols et la santé des terres, y compris les modèles prédictifs fondés sur le LDSF dont il a été question dans la section 2.1.
3.1.4 Un exemple pratique : accéder à un jeu de données de la GMV via STAC
Voici, étape par étape, à quoi ressemblent la découverte et l’accès à un jeu de données par l’intermédiaire de notre catalogue STAC :
| 1. Se connecter au catalogue | Pointez l’outil de votre choix (R, Python, extensions QGIS) vers le point d’accès de notre API STAC, point de départ unique pour tout ce qui se trouve dans la collection GMV. |
| 2. Rechercher dans la collection | Interrogez le catalogue pour l’élément dont vous avez besoin, par exemple le carbone organique du sol, éventuellement filtré par zone d’intérêt et par date. |
| 3. Examiner le résultat | Chaque correspondance est renvoyée sous forme d’élément STAC, avec des métadonnées décrivant ce qu’il est, sa couverture et des liens vers ses actifs. |
| 4. Récupérer l’actif | Suivez le lien vers le fichier proprement dit, dans notre cas un Cloud Optimized GeoTIFF (COG), qui peut être diffusé directement plutôt que téléchargé en entier. |
| 5. Charger les données | Grâce au format COG, vous pouvez ne demander que la zone qui vous intéresse, même à partir d’un fichier couvrant toute la GMV. |
Ce type de flux de travail peut être mis en œuvre avec de nombreux outils différents, que nous explorerons dans la section 3.2. Ce portail utilise une configuration R et RStudio ; passons à la section suivante pour commencer.
En savoir plus
En savoir plus sur la spécification SpatioTemporal Asset Catalog (STAC), ainsi que sur les différents outils et guides.
Un index interrogeable de catalogues et d'API STAC accessibles publiquement, provenant de fournisseurs du monde entier.