2.1 Comment les données probantes spatiales sont générées
Dans la section 1.3, nous avons examiné comment les données probantes spatiales sont produites et comment les différentes sources de données, méthodes et hypothèses peuvent toutes influencer ce que montre une carte ainsi que le degré de confiance avec lequel elle peut être utilisée.
Cette section s’appuie sur ces fondations en trois parties : un flux de travail général allant des données brutes ou des observations aux données probantes, les différents formats de données probantes spatiales, l’observation de la Terre en tant que source de plus en plus importante derrière de nombreux produits de données probantes spatiales et, enfin, les étapes spécifiques utilisées pour générer les jeux de données à l’origine de ce portail, du terrain aux données ouvertes.
2.1.1 Des observations aux données probantes
Dans le contexte de la restauration des paysages, les données probantes spatiales sont les résultats analysés ou modélisés dérivés de données spatiales (des données comportant une information de localisation) qui aident à décrire l’état et les tendances des paysages, et à éclairer les décisions. Elles peuvent être présentées sous divers formats, notamment des cartes statiques ou interactives, des graphiques, des diagrammes, des tableaux de bord, des tableaux récapitulatifs et d’autres visualisations. Ce portail se concentre principalement sur les données probantes spatiales présentées sous forme de cartes, bien que les mêmes principes s’appliquent à l’interprétation de n’importe lequel de ces formats.
Les données probantes spatiales sont, en fin de compte, le produit de différents types d’observations du monde provenant d’une grande variété de sources : satellites, aéronefs, stations météorologiques, échantillons de terrain directs, capteurs IoT, enquêtes auprès des ménages, données de science citoyenne, et bien plus encore.
Passer d’une observation brute à un élément de preuve exploitable implique presque toujours un certain degré de traitement, de transformation ou de combinaison avec d’autres données. Dans notre monde riche en données, les produits de données probantes spatiales combinent de plus en plus plusieurs sources pour produire des résultats plus riches et plus informatifs.
Observer Collecter des données/observations du monde
satellites · données de terrain · capteurs
Traiter Préparer les données et en contrôler la qualité
correction · nettoyage · étalonnage
Analyser / modéliser Transformer, combiner et analyser les données
indices · synthèses · comparaisons · prédictions
Produit Représenter l’information dans l’espace
cartes · indicateurs · jeux de données
Données probantes Interpréter par rapport à une question ou à une décision
Les données probantes spatiales sous forme de données raster (et autres)
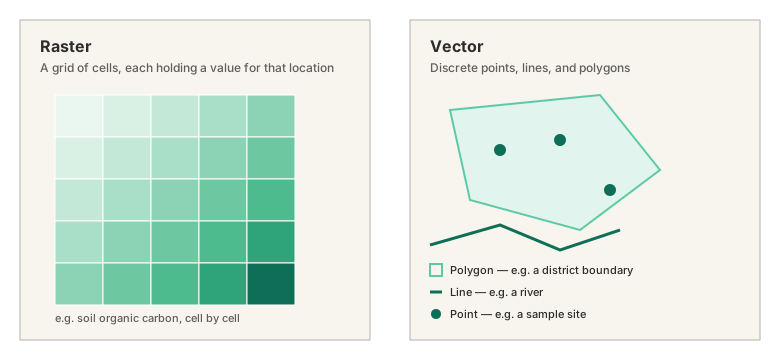
Les données probantes spatiales sont généralement représentées selon l’un de deux grands formats : raster ou vecteur.
Un raster représente un paysage sous la forme d’une grille continue et régulière de cellules (pixels), chaque cellule stockant une valeur. Cela fait du raster le meilleur format pour saisir des variables continues et, parfois, catégorielles.
Un vecteur représente des entités discrètes à l’aide de points, de lignes et de polygones. Les points peuvent représenter des observations de terrain ou des sites d’échantillonnage ; les lignes, des cours d’eau ou des routes ; et les polygones, des champs, des aires protégées, des limites administratives ou des zones de projets de restauration.
Pourquoi travaille-t-on autant avec des données raster ?
Les conditions environnementales sont généralement des variables continues, c’est-à-dire que leurs propriétés observables tendent à changer et à varier de façon continue à travers des paysages entiers. Un raster permet de représenter cette continuité en stockant une valeur pour chaque pixel sur l’ensemble du paysage.
C’est aussi ainsi qu’est générée une grande partie de nos données probantes spatiales : les satellites d’observation de la Terre mesurent la surface terrestre sous forme de grilles de pixels et, souvent en conséquence, les modèles statistiques et d’apprentissage automatique utilisés pour estimer les conditions environnementales sur de vastes zones produisent fréquemment leurs résultats dans ce même format en grille. Les données raster sont particulièrement utiles pour comparer les conditions sur de vastes zones, identifier des motifs et des tendances spatiaux, et combiner plusieurs indicateurs environnementaux.
Les données raster et vectorielles sont souvent utilisées conjointement. Par exemple, nous pouvons utiliser une carte raster pour visualiser l’état de la végétation à l’échelle d’un pays entier et y superposer des limites vectorielles afin de résumer les valeurs par district, par site de restauration ou par d’autres zones d’intérêt. Pour en savoir plus sur les formats de données spatiales, cliquez ici (en anglais).
L’observation de la Terre : un apport croissant et de plus en plus essentiel
L’observation de la Terre (OT), c’est-à-dire l’imagerie satellitaire et aérienne répétée de la surface terrestre, est l’une des sources de données les plus importantes alimentant les données probantes spatiales.
Historiquement, elle était coûteuse et contrôlée par un petit nombre d’agences spatiales nationales. Mais au cours des deux dernières décennies, la situation a considérablement changé : le nombre de missions satellitaires publiques et commerciales croît rapidement et les principaux fournisseurs ont adopté des politiques de données gratuites et ouvertes. Des observations cohérentes et répétées de la surface de la Terre sont ainsi désormais disponibles en accès libre, à des résolutions spatiales et temporelles toujours plus fines, sur presque toute la planète.
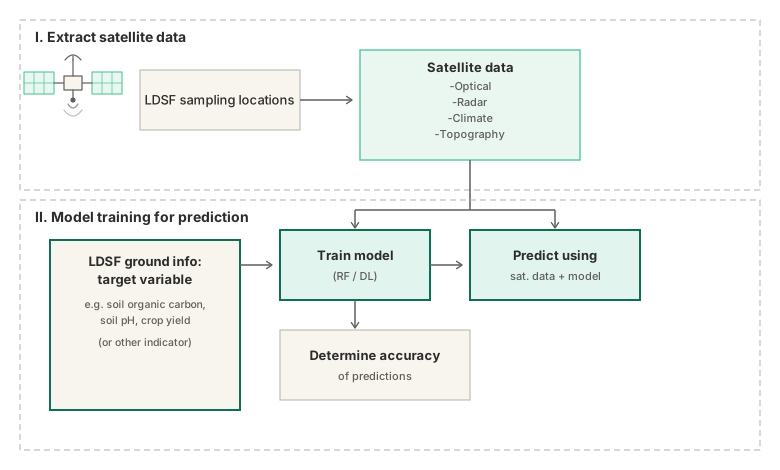
Les données d’OT, à elles seules, peuvent détecter et mesurer des propriétés physiques de la surface terrestre, comme la lumière réfléchie ou la rétrodiffusion radar, mais elles sont incapables de mesurer des éléments tels que le carbone organique du sol, la biomasse ligneuse ou la biodiversité, qui nécessitent généralement un échantillonnage au sol pour entraîner et valider les modèles. La combinaison de l’OT et des données de terrain est très puissante : elle nous permet de produire des données probantes spatiales à la fois continues dans l’espace et ancrées dans des mesures du monde réel.
Différents degrés de transformation
Des mesures directes aux indicateurs dérivés, aux synthèses temporelles et aux prédictions modélisées, les étapes de traitement sont de plus en plus nombreuses et, à chaque étape, davantage d’hypothèses sont introduites et les erreurs ont plus d’occasions de se propager et de se cumuler. La section 2.2 reprend ce point plus en détail, à travers des exemples concrets et des considérations techniques à prendre en compte lorsqu’on utilise des données probantes spatiales pour appuyer des décisions.
2.1.2 La chaîne de production de données probantes de K4GGWA
Le processus général décrit ci-dessus s’applique directement à la manière dont les produits de données probantes disponibles sur la plateforme K4GGWA sont générés. Nous parcourons ci-dessous cette chaîne, de l’échantillonnage systématique sur le terrain à l’accès aux données ouvertes et à la prise de décision, en passant par l’analyse en laboratoire et la modélisation.
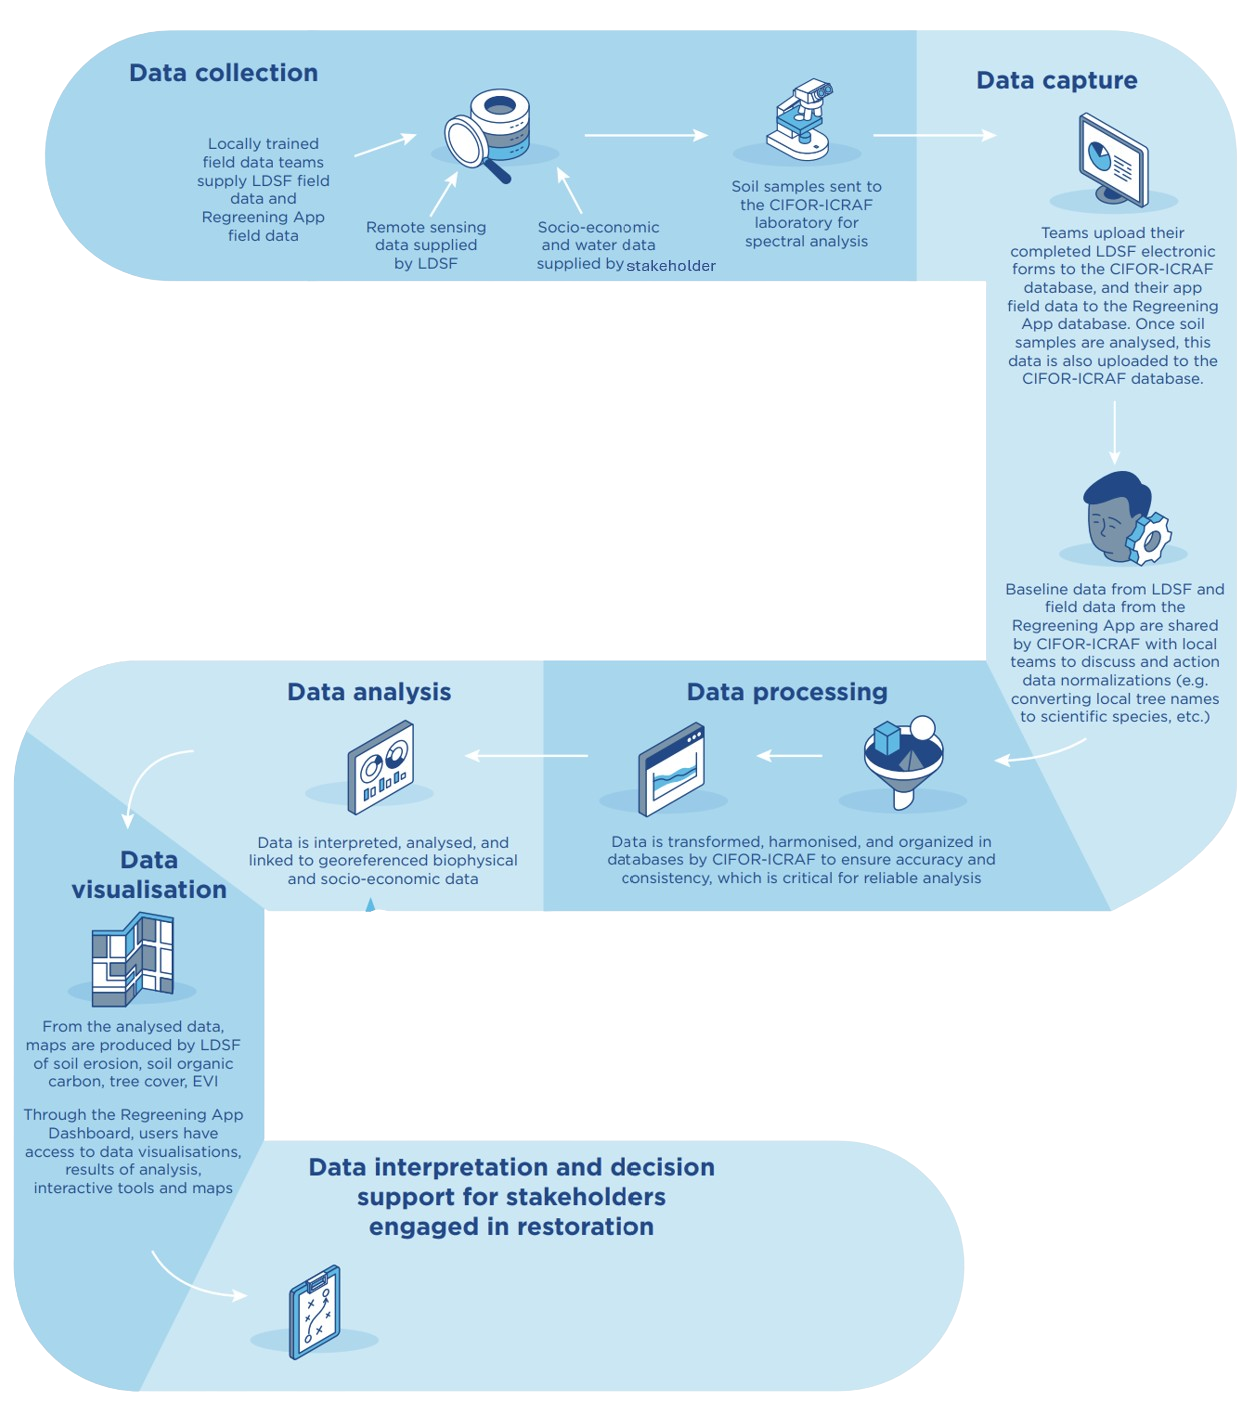
Pour un parcours plus détaillé du processus suivi pour générer les produits de données probantes sur les sols et la santé des terres disponibles sur ce portail, explorez les étapes ci-dessous, ainsi que la section Articles et méthodes pour davantage de détails techniques sur les méthodes utilisées pour générer les jeux de données.
Chaîne de suivi des sols et de la santé des terres de K4GGWA
LDSF - Échantillonnage systématique sur le terrain
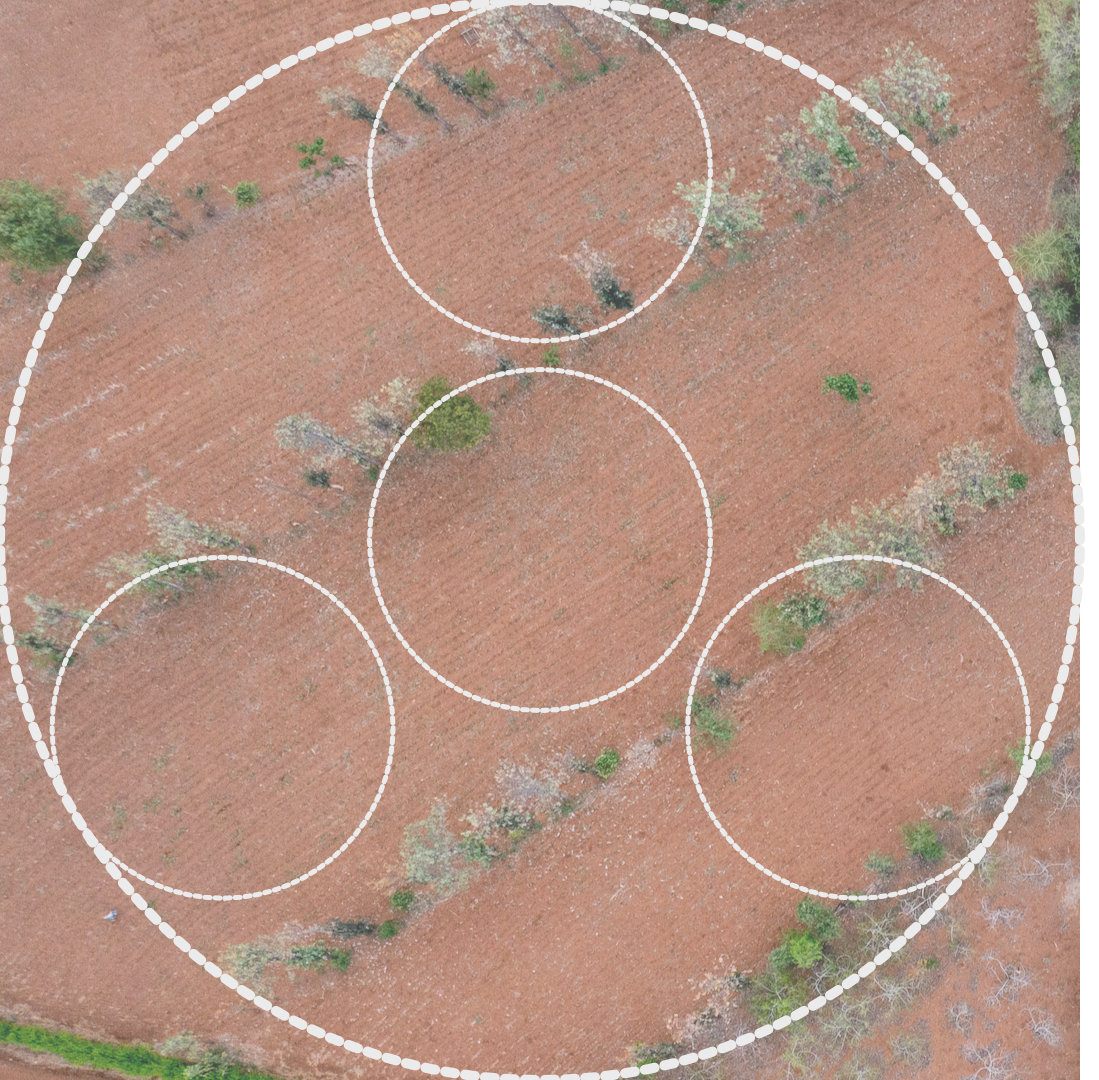
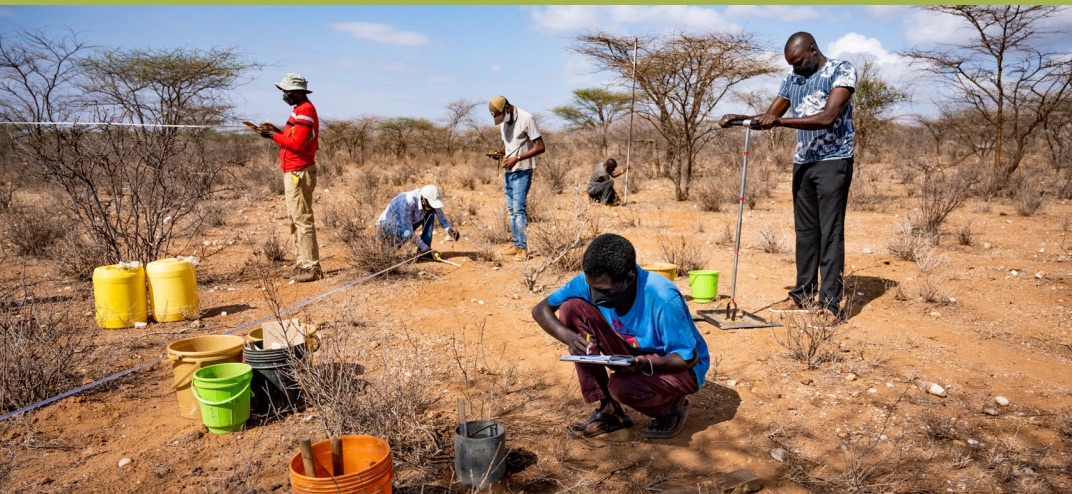
La collecte de données de terrain suit le Cadre de surveillance de la dégradation des terres (LDSF), un plan d'échantillonnage systématique et emboîté utilisé dans les divers paysages africains, y compris dans l'ensemble des pays de la GMV.
Les sites sont sélectionnés au hasard au sein d'un paysage. Chaque site est un quadrat de 10 km x 10 km contenant 16 grappes, chacune composée de 10 parcelles, elles-mêmes divisées en 4 sous-parcelles. Ce plan emboîté et multi-échelle capte la variation spatiale à plusieurs échelles au sein d'un même paysage, ce qui limite au minimum les biais des données obtenues et en fait une base solide pour la modélisation décrite plus loin dans cette chaîne.
Le cadre est conçu pour collecter des données sur les sols et la santé des terres, telles que la prévalence de l'érosion, les propriétés physico-chimiques des sols et la biodiversité, mais il peut être étendu avec des modules supplémentaires selon le contexte, par exemple les modules parcours ou ADNe, de sorte que le même plan de base puisse être adapté à différents paysages et besoins de suivi.
Laboratoires régionaux d'analyse des sols
En plus des échantillons physiques de sol, les équipes de terrain enregistrent des données d'observation directement au moyen d'un formulaire numérique (ODK), notamment la prévalence de l'érosion et d'autres indicateurs évalués visuellement, les espèces végétales identifiées, les mesures de biomasse, et plus encore. Chaque échantillon physique est ainsi associé à des observations de terrain riches et géolocalisées.
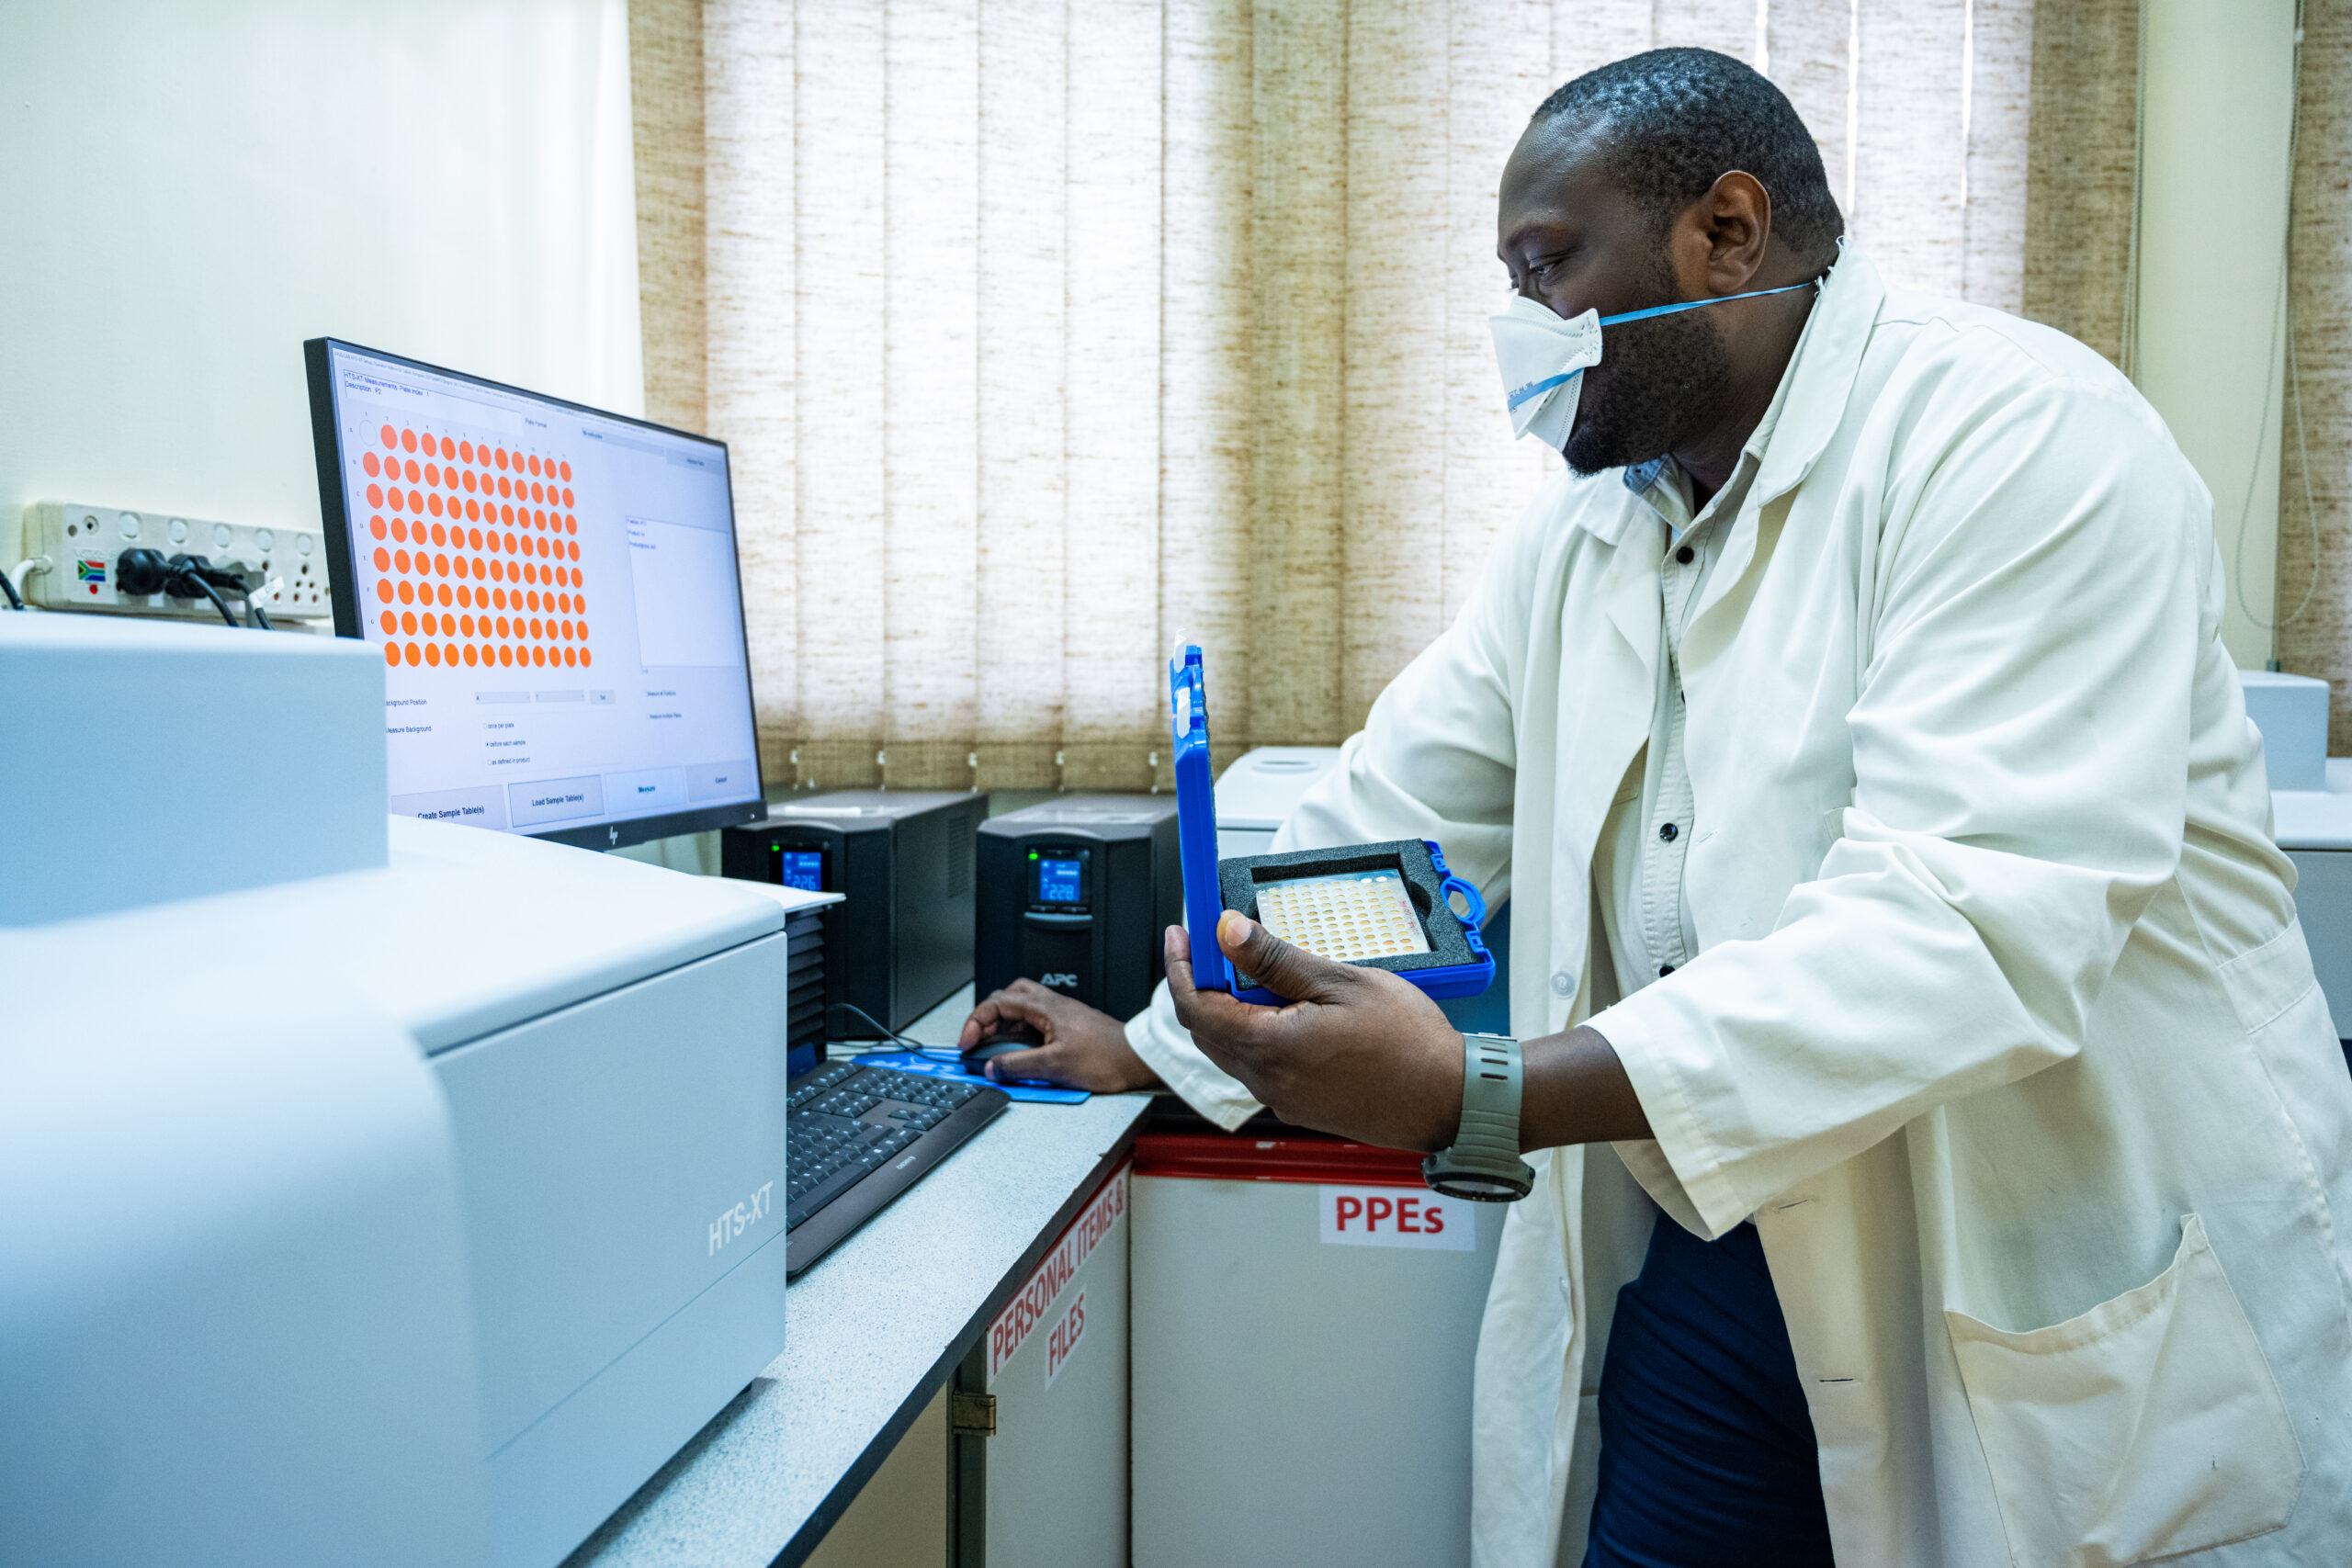
Les échantillons physiques sont transportés soit vers le laboratoire principal du World Agroforestry à Nairobi, soit vers l'un des laboratoires régionaux d'analyse des sols d'un réseau en expansion, dans le cadre des efforts en cours pour renforcer les capacités des laboratoires régionaux.
Au laboratoire, les échantillons sont traités par notre système d'information de laboratoire (LIMS) et analysés à l'aide de la spectroscopie de pointe ainsi que d'autres équipements, ce qui permet des analyses à haut débit et de haute précision à une échelle qui ne serait pas réalisable avec les méthodes classiques de chimie par voie humide.
Construction de la base de données LDSF
Les résultats de laboratoire et les observations collectées sur le terrain (ODK) sont traités, nettoyés et contrôlés en qualité, puis intégrés dans la base de données LDSF.
Cette base de données, qui comprend la plus grande bibliothèque spectrale de sols d'Afrique, ainsi que les données associées sur les plantes et la santé des terres, constitue le réservoir à partir duquel sont élaborés tous les produits analytiques en aval. Tout ce qui est décrit dans les deux étapes suivantes dépend de la qualité et de la cohérence établies à ce stade.
Analyses et modélisation prédictive
La base de données LDSF sert à entraîner des modèles d'apprentissage profond de la santé des terres, qui combinent des mesures de référence issues du terrain avec l'imagerie d'observation de la Terre et d'autres covariables environnementales (voir la note sur l'observation de la Terre ci-dessus) afin de prédire les conditions de manière continue à travers le paysage, et non seulement aux emplacements échantillonnés.
Il s'agit de la même étape « des points aux prédictions » présentée dans le flux de travail général ci-dessus, appliquée à grande échelle, à l'aide de modèles avancés pour générer des produits raster continus accompagnés de mesures explicites de l'incertitude, afin de connaître la valeur prédite en tout point et le niveau de confiance dans le résultat.
Accès aux données ouvertes
Les produits de données obtenus sont publiés via une infrastructure de données ouverte reposant sur STAC, comprenant un catalogue dédié à la GMV qui est interopérable, transparent et conforme aux principes FAIR, de sorte que les cartes, les métadonnées et les ressources sous-jacentes puissent être réutilisées dans différents flux de travail et contextes décisionnels.
Pour de nombreux indicateurs pertinents pour la GMV, ces produits sont plus performants que les jeux de données mondiaux disponibles par défaut, et les praticiens techniquement compétents peuvent aller encore plus loin en combinant les données sous-jacentes et en s'appuyant sur elles pour générer leurs propres données probantes.
Dans la section suivante, 2.2, nous explorons les questions pratiques et les points à considérer lors de l’intégration de données probantes dans nos décisions : la qualité et les biais possibles des données sous-jacentes, les étapes de transformation nécessaires pour produire le résultat final, la disponibilité de métadonnées permettant de vérifier tout cela, ainsi que des questions pratiques sur les données probantes elles-mêmes, notamment la variable représentée, l’unité de mesure, la résolution spatiale et temporelle, et la façon dont elles peuvent être combinées à d’autres données probantes pour appuyer une décision plus éclairée.
En savoir plus
Découvrez le Cadre de surveillance de la dégradation des terres (LDSF) et la chaîne utilisée pour générer les produits de données probantes sur les sols et la santé des terres disponibles sur ce portail.
Explorez et apprenez-en davantage sur différents types de méthodes de modélisation statistique géospatiale et de transformations, notamment la régression, l'interpolation et l'apprentissage automatique.